六個模型、零秘密:K2 Horizon——史上最大規模的全開源 AI 釋出
MBZUAI 基礎模型研究所一次釋出六個 Apache 2.0 授權的模型,參數規模從 0.9B 到 375B,連訓練程式碼、訓練資料與方法論全部公開——這是前沿實驗室有史以來最徹底的透明化釋出。
六個模型、零秘密:K2 Horizon——史上最大規模的全開源 AI 釋出
2026 年 9 月 3 日,阿布達比穆罕默德·本·扎耶德人工智慧大學(MBZUAI)旗下的基礎模型研究所(Institute of Foundation Models,IFM)發布了 K2 Horizon——一個涵蓋六個基礎模型、參數規模從 0.9B 橫跨到 375B 的模型家族。在一個每週都有前沿模型問世的產業裡,單看這件事並不稀奇。真正讓這次發布寫進歷史的是隨模型一起公開的東西:模型權重、訓練程式碼、訓練資料與配方、配置、評測結果與完整方法論——全部公開,全部採用 Apache 2.0 授權。
IFM 稱之為「AI 歷史上最大規模的全開源模型釋出」,這個說法很難反駁。目前市面上多數被稱為「開放」的釋出,通常只做到公開權重——一個下載連結加一份授權條款。K2 Horizon 則打開了整條開發流程。路透社也獨立報導,這是一次罕見地以「可重現性」而非單純「權重取得」為核心的開源行動。
這和「開放權重」有什麼不同?
時機點很有意思。這次釋出正好落在產業激烈辯論「開放」一詞到底意味著什麼的當口,而 IFM 的發布資料毫不掩飾地劍指近幾週佔據新聞版面的「開放權重」論戰。
這個區別至關重要。開放權重的釋出讓你能下載模型、執行模型,但你看不到它是怎麼被造出來的。你無法重現訓練過程、無法審計資料混合比例、也無法研究能力湧現的關鍵中間檢查點。你只能相信實驗室的基準測試數據,以及它對訓練資料的描述。全開源釋出則徹底翻轉了這層關係:所有宣稱都變成可驗證的。
「開源遠不止於開放權重。科學之所以能運作,是因為別人能看到資料、跟上方法、重現結果、然後改進它,」IFM 創辦人兼 MBZUAI 校長邢波(Eric Xing)表示。「K2 Horizon 兌現了這個需求。家族中的每個模型都附帶它的訓練資料、配方與評測結果。這是開放科學,我們相信這是 AI 最好的前進道路。」
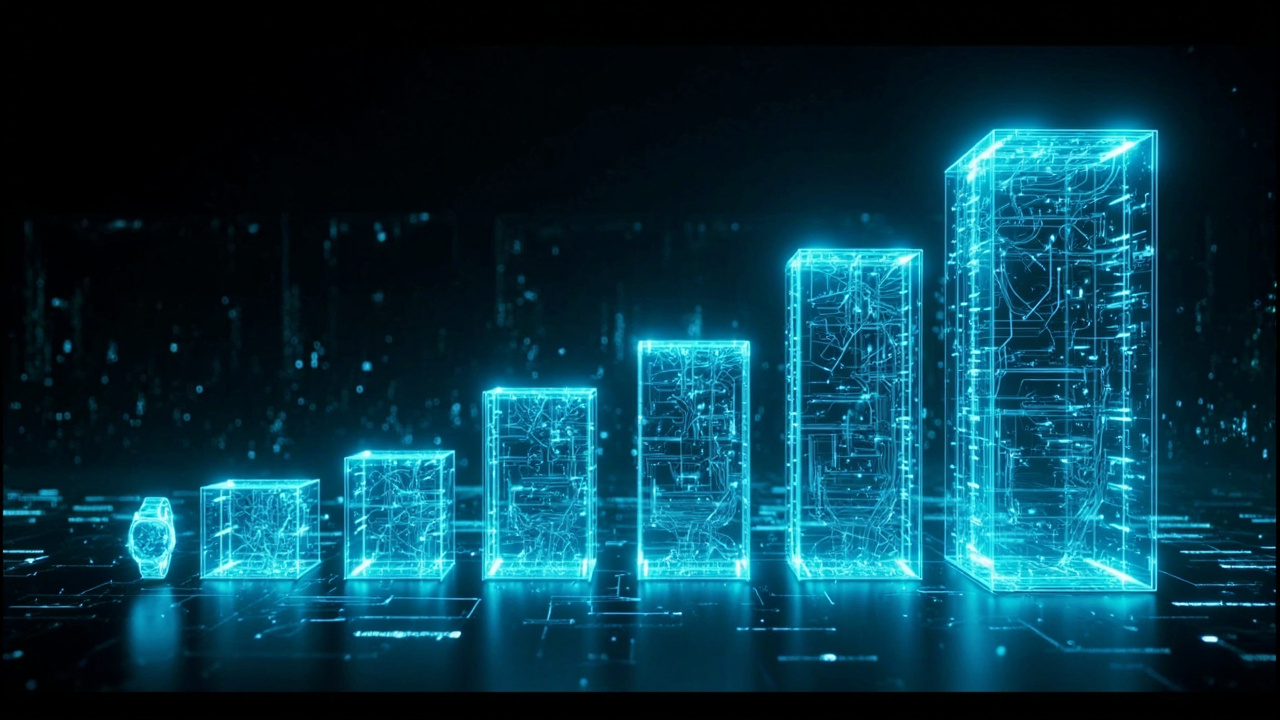
模型家族:從手腕到資料中心
六個模型共享核心架構、詞彙表、訓練方法論、介面與部署工具鏈(僅 0.9B 版本使用較小的詞彙表)。設計意圖是讓開發者從原型到正式環境走一條連續的路徑,中途不需要更換模型家族或工作流程:
- 0.9B — 根據 IFM 的說法,是同等規模中數學、推理與工具使用表現最佳的模型,小到可以跑在智慧手錶上;鎖定能源、物流、醫療與公共服務等邊緣部署場景。
- 3.7B — 對開發者最友善的微調尺寸,推理能力號稱 4B 以下業界最強,匹敵甚至超越許多更大的模型。
- 7B — 宣稱是 10B 參數以下表現最佳的模型,軟體工程與深度研究能力突出;可直接跑在手機上。
- 32B — 稠密架構,為筆電與地端伺服器的高強度使用而建,是最適合本地部署的稠密模型之一。
- 36B-A4B — 稀疏模型,每個 token 僅啟動 4B 參數,導入全新的「價值注意力混合」(Mixture of Value Attention,MoVA)架構,IFM 稱其效能勝過許多更大的模型。
- 375B-A23B — 旗艦:稀疏混合專家(MoE)模型,總參數 375B、每 token 約啟動 23B,原生支援 524,288 token 上下文視窗,設計目標是在推理與代理式任務上與領先的開放權重模型正面競爭。
IFM 表示,最小的三個模型(0.9B、3.7B、7B)在數學、推理、軟體工程與代理式能力上,於各自尺寸級距創下新的技術水準。圍繞 375B 旗艦的社群基準測試貼文則引用了 GPQA Diamond 87%、Terminal-Bench 2.1 約 72% 的成績——數字亮眼,但在獨立評測累積之前仍屬官方自行報告。
三項底層新技術
K2 Horizon 的技術故事建立在 IFM 宣稱的三項創新上:
- 擴散蒸餾(diffusion distillation) — 平行生成整個 token 區塊而非逐一生成,在不損失回應品質的前提下將推理速度提升約 3 倍。
- 價值注意力混合(MoVA) — 一種在不增加運算量的前提下提升推理能力的架構創新,驅動 36B-A4B 模型。
- 動態模型路由(dynamic model routing) — 自動將任務導向家族中最具成本效益的模型,為開發者提供從原型到量產的實用路徑。
血脈清晰可見。這條軌跡始於最初的 K2,行經 K2-Think 與 K2 Think V2,在 Horizon 達到最寬廣的實踐。每一代都開放更多技術堆疊;Horizon 則幾乎全開。
「全開源」的但書
誠實起見,必須指出時間上的細節。IFM 的發布資料把訓練生命週期描繪為釋出的一部分,但 375B-A23B 旗艦目前在 Hugging Face 上的模型卡指出:最終檢查點現已可用,而中間檢查點、資料與訓練程式碼「將陸續釋出」——部分產物仍在分階段上架。當再散布權利不允許直接公開資料集時,IFM 表示會提供來源描述、過濾程序、建構方法與混合比例,而非原始資料本身。
而且,開放不等於便宜。IFM 自己為旗艦發布的 SGLang 服務配方,是在八節點 H200 上以張量平行與專家平行、BF16 精度及 FlashAttention-3 驗證的。權重可以免費下載;正式環境等級的推理仍然是資料中心等級的投資。
可用性倒是相當全面:權重在 Hugging Face,vLLM、SGLang 與 Ollama 第一天就支援,可在 NVIDIA、AMD 與 Cerebras 硬體上部署,並透過包括 Compass、Cerebras、AWS 與 Nebius 在內的推論合作夥伴提供 API。
為什麼是一所大學在做這件事?
策略背景是阿聯酋的全國 AI 豪賭。IFM 成立於 2025 年 5 月,目前在三個辦公室運作——阿布達比、矽谷與巴黎——把前沿模型開發放在阿聯酋,同時從全球既有重鎮汲取人才。其產品組合還包括 K2 系列、阿拉伯語-英語的 Jais 模型,以及用於具身推理的世界模型 PAN。
「我們這個時代最重要的技術,應該與世界共同建造,而不是藏起來,」邢波說。「K2 Horizon 就是一個機構完全兌現這個信念的樣子,也反映了我們在阿聯酋所處的環境:這個國家決定自己建造 AI,而不是等著 AI 降臨。」
後續觀察指標
2026 年的開源生態競爭激烈——Kimi K3、GLM-5.2、Qwen 3.8、GPT-OSS、Nemotron 3——但它們幾乎清一色是「開放權重」釋出。K2 Horizon 改變了競爭的條款:如果它的數字經得起獨立檢驗,問題就不再是「哪個開放模型最好?」,而是「你的實驗室為什麼還在藏訓練資料?」
值得觀察的指標:承諾的中間檢查點與資料是否如期上架;獨立評測能否證實小模型的 SOTA 宣稱(這是最容易證偽的部分);以及動態路由是否真能作為家族層級的產品功能發揮作用,而非只停留在論文裡。如果這些檢驗全部過關,2026 年 9 月 3 日或許會被記住——作為「開源 AI」終於名副其實的那一天。
Sources
- [1] https://mbzuai.ac.ae/news/mbzuais-institute-of-foundation-models-launches-k2-horizon-the-worlds-largest-fully-open-ai-models-in-history/
- [2] https://www.prnewswire.com/news-releases/institute-of-foundation-models-launches-the-industrys-largest-fully-open-source-fleet-of-ai-models-complete-with-weights-code-training-data-and-methodologies-302868628.html
- [3] https://www.hpcwire.com/aiwire/2026/09/03/institute-of-foundation-models-releases-fully-open-k2-horizon-models-with-weights-code-and-training-data/