OpenAI 大手筆購入數萬台 Mac 跑強化學習 — 蘋果意外成為 AI 硬體公司
The Information 報導 OpenAI 已購入數萬台 Mac 執行強化學習工作負載,Anthropic 則透過 AWS 租用 Mac 運算資源;Nvidia 現在將蘋果視為本地 AI 運算的主要競爭對手。
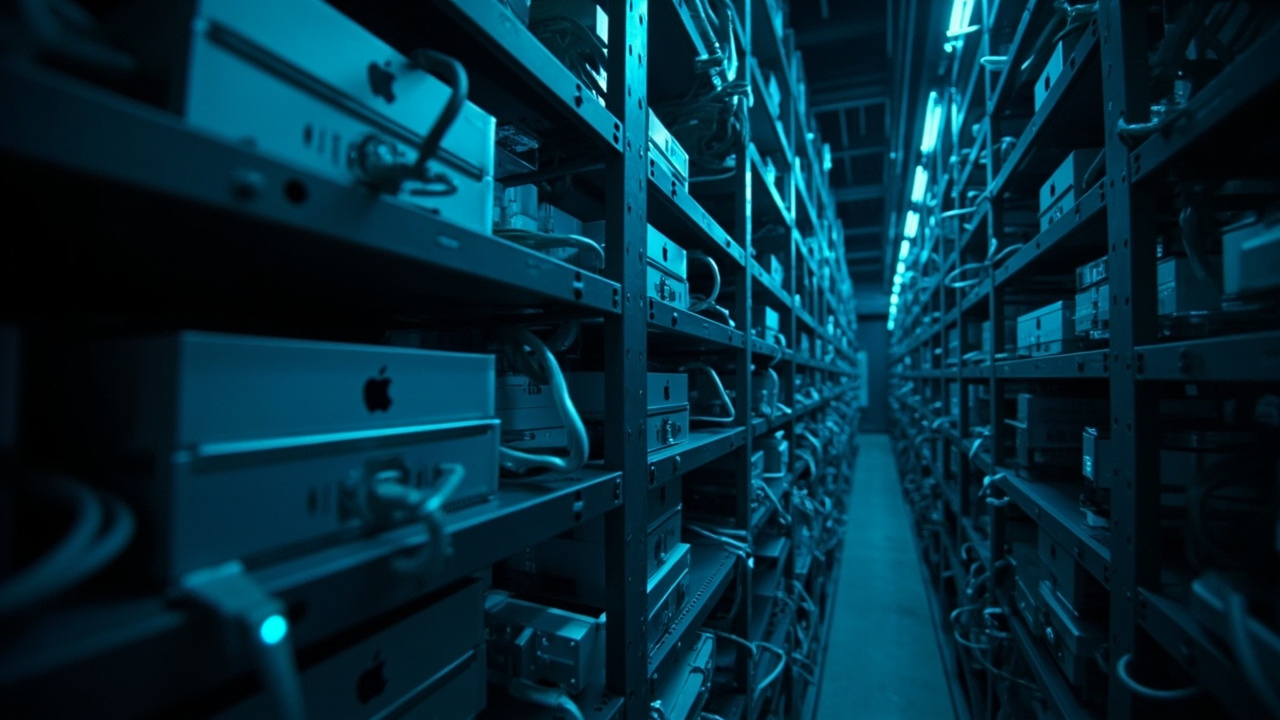
蘋果當前最搶手的產品,不是 iPhone、不是 iPad,也不是 Apple TV+ 上的熱門影集。根據 The Information 記者 Aaron Tilley 週日發布的報導,答案是 Mac 產品線中兩個最不起眼的成員:方方正正、不附螢幕鍵盤滑鼠的 Mac mini 與 Mac Studio。AI 實驗室與新創雲端業者正一卡車一卡車地採購這兩款機器,而買家名單中包括全球身價最高的 AI 公司。
報導內容
The Information 報導,OpenAI 已購入數萬台 Mac,用於執行強化學習(reinforcement learning)工作負載。至於 Anthropic,則是透過 Amazon Web Services 租用 Mac 運算資源,而非直接整批購買——AWS 提供EC2 Mac 執行個體已有多年,而 Anthropic 選擇租賃路線,暗示這股需求訊號已強到超大型雲端業者開始把 Apple Silicon 包裝成計費服務來賣。報導細節雖在付費牆之後,但核心結論毫無歧義:前沿 AI 實驗室正把 Mac 硬體當成正式的 AI 基礎設施,而不是開發者的便利品。
第二項發現其實更重要:Nvidia 現在將蘋果視為其在本地 AI 運算領域的主要競爭對手。這句話放在一家近年 AI 敘事始終是笑柄的公司身上,格外令人吃驚——蘋果姍姍來遲加入大模型戰局、搞砸了 Siri 的大改版,隨後又眼睜睜看著與 OpenAI 的合作關係惡化成訴訟。多年來 Nvidia 心目中的本地 AI 對手是 AMD、頂多加上 Intel;如今讓黃仁勳夜不能寐的對手,居然是 MacBook 的製造商。
為什麼 Mac 突然能跑正式的 AI 工作負載
技術核心在於統一記憶體(unified memory)。Apple 的 M 系列晶片將 CPU 與 GPU 放在同一封裝上,共用一池高頻寬記憶體——新款 M5 Ultra 最高可達 512GB,頻寬 1.2TB/s。相較之下,Nvidia H100 僅有 80GB HBM,連 GB300 也只有 288GB。對大模型推論而言,瓶頸在於能否把模型權重與 KV cache 塞進快速記憶體;以單位美元可用的記憶體容量來算,一台 Mac Studio 勝過 Nvidia 型錄裡的任何產品——M5 Ultra 機種起價 5,499 美元,而一台滿配 GPU 伺服器要價六位數。
強化學習帶來第二層更微妙的優勢。RL 工作負載會產生海量 rollout——政策模型產出內容、獎勵模型評分、訓練迴圈重複數百萬次。這其中大部分環節的形態其實接近推論而非訓練:對一個凍結的模型做快速、大規模並行的生成。各實驗室發現,用跑 Apple 開源陣列框架 MLX 的 Mac 機群處理這類工作,成本遠低於把稀缺的頂級 GPU 燒在 rollout 上。去年 12 月的 macOS 26.2 更加入了 Thunderbolt 5 低延遲互連、支援分散式 MLX 推論,實質上讓一串 Mac mini 能像單一大記憶體池般運作——從那時起,業餘玩家與實驗室都在競相串接機器。
財報數字早已洩漏答案
營收數據印證了這則報導。蘋果 2026 會計年度第三季(7 月 30 日公布)Mac 營收達 104 億美元、年增 29%——Mac 史上最強的六月季度成績——而總營收 1,094 億美元也創下紀錄。同一時間,Tim Cook 的公司以零組件成本為由,將部分 Mac 與 iPad 調漲最多 25%,並預警 Mac 產品線將出現供應吃緊。「AI 買家的需求面壓力」是少數能同時解釋這三件事的答案。當時分析師已指出成長主要來自 AI 推論與開發者用途;The Information 的報導如今把買家的名字指了出來。
值得停下來品味這份諷刺:蘋果當年設計 M 系列架構是為了省電的消費性運算。統一記憶體之所以存在,是因為手機 SoC 負擔不起獨立顯示記憶體。2019 年蘋果規劃產品線時,沒有人想像過 OpenAI 會數萬台數萬台地買走配備 512GB M5 Ultra 的機器。正如 The Information 標題所言,蘋果是「跌進」AI 硬體成功的——這是兆美元公司被自家最成功的產品轉向打了個措手不及的罕見案例。
對 Nvidia 意味著什麼
Nvidia 的反應本身就是最強訊號。該公司 2026 年一直在往這則新聞所威脅的方向布局:DGX Spark 與 RTX 消費線拚本地 AI、Vera CPU 與網路拚整機架系統、實體 AI 業務年營收跑速已達約 100 億美元。但 Nvidia 的本地 AI 產品記憶體上限遠低於 512GB 統一記憶體,定價也預設買家是資料中心。如果前沿實驗室——更重要的是,成千上萬在本地跑 Qwen、DeepSeek 等開放權重模型的中小企業——能用平價的 Mac 滿足推論需求,Nvidia 最高毛利資料中心 GPU 的潛在市場就會在邊際上被侵蝕。
這正是「蘋果成為本地 AI 主要對手」比聽起來更嚴重的原因。它把 AI 硬體競賽的框架,從「誰有最快的訓練加速器」改寫成「誰掌握推論實際發生的基底」。在這個框架下,2020 年以來出貨的數億台 Apple Silicon 裝置——每一台 Mac、iPad 與高階 iPhone——都成了 GPU 廠商無法匹敵的潛在 AI 基礎設施。
開放權重模型的角色
把这一切串起來的最後一條線,是開放權重生態系。買 Mac 機群的經濟學只有在「你擁有可以跑在自己硬體上的模型」時才成立。Qwen、DeepSeek、Kimi 與快速進步的開放權重模型家族,正好給了每個實驗室與企業這個選項。當 Anthropic 在 AWS 租 Mac、OpenAI 直接整批購入,兩者都在用行動押注:本地推論開放模型已是一級工作負載——而他們的錢流向了蘋果,不是 GPU 新創雲。
對蘋果而言,這是花錢也買不到的 AI 成功故事:不是前沿模型,不是 Siri 復興,而是全球 AI 領袖們默默搶著要的晶片。對其他正在規劃 2027 年 AI 基礎設施的人來說,這個週末報導傳達的訊息很簡單——先把「每美元能買到的記憶體」算清楚,然後確認答案會不會是一台桌上型電腦。
來源
- The Information — How Apple Stumbled Into AI Hardware Success With the Mac
- AI Weekly — AI News Today, August 30
- Ars Technica — With new Mac Studio and Mac mini, Apple leans hard into local AI inference
- TechTimes — Apple Q3 2026 earnings: record revenue, Mac +29%
- Yahoo Finance — Apple Q3 2026 earnings beat estimates
Sources
- [1] https://www.theinformation.com/articles/apple-stumbled-ai-hardware-success-mac
- [2] https://aiweekly.co/ai-news-today
- [3] https://arstechnica.com/apple/2026/08/with-new-mac-studio-and-mac-mini-apple-leans-hard-into-local-ai-inference/
- [4] https://www.techtimes.com/articles/322442/20260731/apple-q3-2026-earnings-record-revenue-worsening-mac-supply-below-consensus-q4-outlook.htm
- [5] https://finance.yahoo.com/markets/stocks/articles/apple-q3-2026-earnings-beat-211056445.html